Dunia teknologi sekarang berkembang super cepat, dan salah satu posisi yang naik daun adalah Senior ML Infrastructure Engineer. Posisi ini berada di persimpangan antara machine learning, software engineering, dan infrastruktur. Karena perannya penting banget buat keberlangsungan sistem AI perusahaan, wajar kalau saingannya ketat. Banyak engineer yang sudah berpengalaman bertahun-tahun pun masih harus bersaing keras buat dapat posisi ini.
Tapi tenang, bukan berarti kamu nggak bisa masuk. Dengan strategi yang tepat, skill yang terus diasah, dan portofolio yang pas, kamu bisa banget bersaing dengan kandidat lain. Artikel ini bakal bahas trik-trik jitu yang bisa bikin kamu lebih diperhitungkan dan memperbesar peluangmu diterima jadi Senior ML Infrastructure Engineer. Gaya bahasanya santai aja, tapi isinya tetap berbobot biar kamu bisa langsung praktik!
baca juga: Cara Biar Cepat Diterima Jadi Senior ML
1. Pahami Peran Senior ML Infrastructure Engineer Secara Menyeluruh
Sebelum kamu melangkah lebih jauh, kamu perlu tahu secara jelas apa yang sebenarnya dilakukan oleh seorang Senior ML Infrastructure Engineer. Ini penting karena akan menentukan skill apa yang harus kamu fokuskan.
Tugas utamanya biasanya meliputi:
- Membangun dan mengelola pipeline machine learning end-to-end.
- Membuat sistem training dan inference yang scalable.
- Merancang arsitektur deployment model.
- Mengembangkan tool internal untuk data scientist dan ML engineer.
- Memastikan model AI bisa berjalan stabil dan hemat biaya.
Dengan memahami peran ini secara mendalam, kamu bisa tahu skill apa yang harus kamu upgrade duluan dan mana yang bisa dipelajari sambil jalan.
2. Bangun Fondasi Skill yang Kuat di Dua Dunia Sekaligus
Untuk bisa bersaing, kamu harus solid di dua dunia: machine learning dan infrastruktur. Banyak kandidat kuat hanya fokus salah satunya, jadi kalau kamu bisa menguasai dua-duanya, peluangmu langsung naik.
A. Fondasi Machine Learning
Minimal kamu harus paham:
- Algoritma dasar (linear regression, decision tree, clustering).
- Training pipeline.
- Preprocessing dan feature engineering.
- Model evaluation dan optimasi.
Nggak harus jadi ahli modelling, tapi kamu harus ngerti logikanya karena kamu akan membangun sistem yang mendukungnya.
B. Fondasi Infrastruktur
Ini bagian yang sering jadi pembeda:
- Linux dan command line.
- Docker dan containerization.
- Kubernetes untuk scaling dan orchestration.
- CI/CD pipeline.
- Load balancing dan distributed systems.
Kalau kamu tahu cara kerja sistem yang besar dan kompleks, value kamu langsung naik di mata perekrut.
3. Kuasai Tools Industri yang Paling Banyak Digunakan
Salah satu trik paling efektif buat masuk ke dunia ML Infrastructure adalah mengerti tools populer yang sudah digunakan perusahaan. Jadi, saat interview, kamu bukan cuma paham teori tapi juga tahu cara implementasinya di dunia nyata.
Tools yang wajib kamu kenal:
- MLOps platforms: MLflow, Kubeflow, Metaflow
- Workflow orchestrators: Airflow, Prefect
- Deployment tools: TensorFlow Serving, TorchServe, BentoML
- Cloud platforms: AWS Sagemaker, Google Vertex AI, Azure ML
- Distributed training: Spark, Ray, Horovod
- Infrastructure as code: Terraform
Semakin banyak tools yang kamu kuasai (minimal konsepnya), semakin mudah kamu dilirik.
4. Bikin Portofolio yang Bukan Kaleng-Kaleng
Ini bagian yang sering dilupakan banyak engineer. Portofolio bukan sekadar kumpulan notebook machine learning biasa. Untuk posisi senior, kamu harus menampilkan proyek yang kompleks, terlihat nyata, dan mencerminkan job desk posisi tersebut.
Portofolio yang bagus itu harus:
- Mencerminkan sistem yang scalable
Contoh: training model besar di cluster Kubernetes. - Menunjukkan otomatisasi
Misalnya: pipeline retraining otomatis pakai Airflow. - Punya deployment yang solid
Contoh: model disajikan dengan load balancing dan auto-scaling. - Dilengkapi dokumentasi arsitektur
Diagram, alasan pemilihan teknologi, dan detail teknis.
Kalau kamu punya satu proyek besar yang mencakup end-to-end pipeline mulai dari data ingestion sampai monitoring, itu sudah cukup untuk membuatmu terlihat seperti kandidat senior.
5. Ikut Kontribusi Open Source Biar Makin Stand Out
Di dunia ML Infra, kontribusi open source punya bobot tinggi. Kenapa? Karena ini menunjukkan kamu bukan cuma pakai tools, tapi ikut membantu memperbaiki ekosistemnya.
Kontribusi yang bisa kamu lakukan:
- Menyempurnakan dokumentasi Kubeflow atau MLflow.
- Menyelesaikan beberapa issue GitHub kecil.
- Membuat utility sederhana untuk membantu MLOps.
- Membuat blog post tutorial seputar pipeline ML.
Kontribusi nggak harus besar. Yang penting konsisten. Saat perekrut lihat GitHub kamu aktif, mereka langsung tahu kalau kamu serius di bidang ini.
6. Perkuat Resume agar Kesan Senior Langsung Terlihat
Recruiter cuma butuh sekitar 6–10 detik buat memutuskan apakah CV kamu layak dipertimbangkan atau tidak. Jadi kamu harus menonjol di awal.
Tips resume supaya lebih “senior”:
- Gunakan headline yang jelas, misalnya:
“Machine Learning Infrastructure Engineer with 5+ years experience” - Tidak hanya sebutkan tugas, tapi tunjukkan hasil konkret, contohnya:
- Mengurangi waktu training model dari 4 jam menjadi 1 jam.
- Menurunkan biaya cloud sebanyak 30%.
- Membangun pipeline otomatis yang mengurangi error hingga 80%.
- Gunakan angka sebanyak mungkin.
Data = kredibilitas. - Tulis teknologi yang kamu kuasai secara jelas dalam satu bagian khusus.
Resume yang kuat adalah tiket awal buat masuk interview.
7. Siapkan Diri untuk Interview Teknis Level Senior
Untuk posisi ini, interviewnya biasanya cukup panjang dan mendalam. Tapi kalau kamu tahu apa saja yang biasanya ditanya, kamu bisa jauh lebih siap.
A. Sistem Design ML
Ini bagian paling penting. Bisa berupa:
- Mendesain pipeline ML end-to-end
- Membangun sistem inference dengan throughput tinggi
- Arsitektur distributed training
Fokus pada scalability, reliability, dan efficiency.
B. Coding Interview
Biasanya lebih ke Python dan problem solving.
Saran: asah dasar struktur data, algoritma, dan coding yang rapi.
C. Machine Learning Theory
Tidak terlalu deep seperti Data Scientist, tapi pastikan paham konsep inti.
D. Behavioral Interview
Ceritakan pengalaman menangani failure di sistem ML dan bagaimana kamu mengatasinya.
8. Bangun Kebiasaan Belajar Konsisten
Bidang ML Infrastructure selalu berubah cepat. Tools baru muncul hampir setiap bulan. Kalau kamu mau terus kompetitif, kamu harus membangun kebiasaan belajar yang konsisten.
Cara update yang santai tapi efektif:
- Ikut komunitas MLOps Indonesia.
- Ikut Discord/Slack komunitas global.
- Baca blog engineering dari Uber, Netflix, Google, dan Spotify.
- Ikut workshop online soal Kubernetes atau MLOps.
Belajar sedikit-sedikit tapi tiap hari jauh lebih efektif daripada belajar berat tapi jarang.
9. Networking Itu Penting, Serius!
Banyak orang dapat pekerjaan senior bukan cuma dari apply online, tapi dari koneksi. Engineer ML Infra yang aktif di komunitas sering lebih cepat dapat peluang.
Cara networking yang nggak bikin canggung:
- Ikut event online atau meetup lokal.
- Chat santai di komunitas telegram/discord ML dan MLOps.
- Share progress dan proyekmu di LinkedIn.
- Bantu jawab pertanyaan orang lain (ini cepat bikin kamu dikenal).
Kadang satu komentar di LinkedIn bisa membawa kamu ke interview beneran.
baca juga: Ormawa Expo 2025 Meriah, Mahasiswa Teknokrat Tunjukkan Semangat Kepahlawanan dan Kolaborasi
10. Pilih Perusahaan Sesuai Tingkat Pengalamanmu
Nggak semua perusahaan punya kebutuhan ML Infra yang sama. Ada perusahaan yang sudah matang dan butuh engineer senior banget. Ada juga perusahaan yang sebenarnya butuh orang mid-level tapi baru buka posisi senior.
Kamu bisa pilih berdasarkan:
- Tingkat tantangan teknis.
- Seberapa besar sistem ML mereka.
- Peluang berkembang jadi lead.
- Budaya kolaborasi tim ML dan DevOps.
Kalau kamu memilih perusahaan yang sesuai, peluang kamu diterima dan berkembang bakal lebih besar.
Penulis: Tanjali Mulia Nafisa
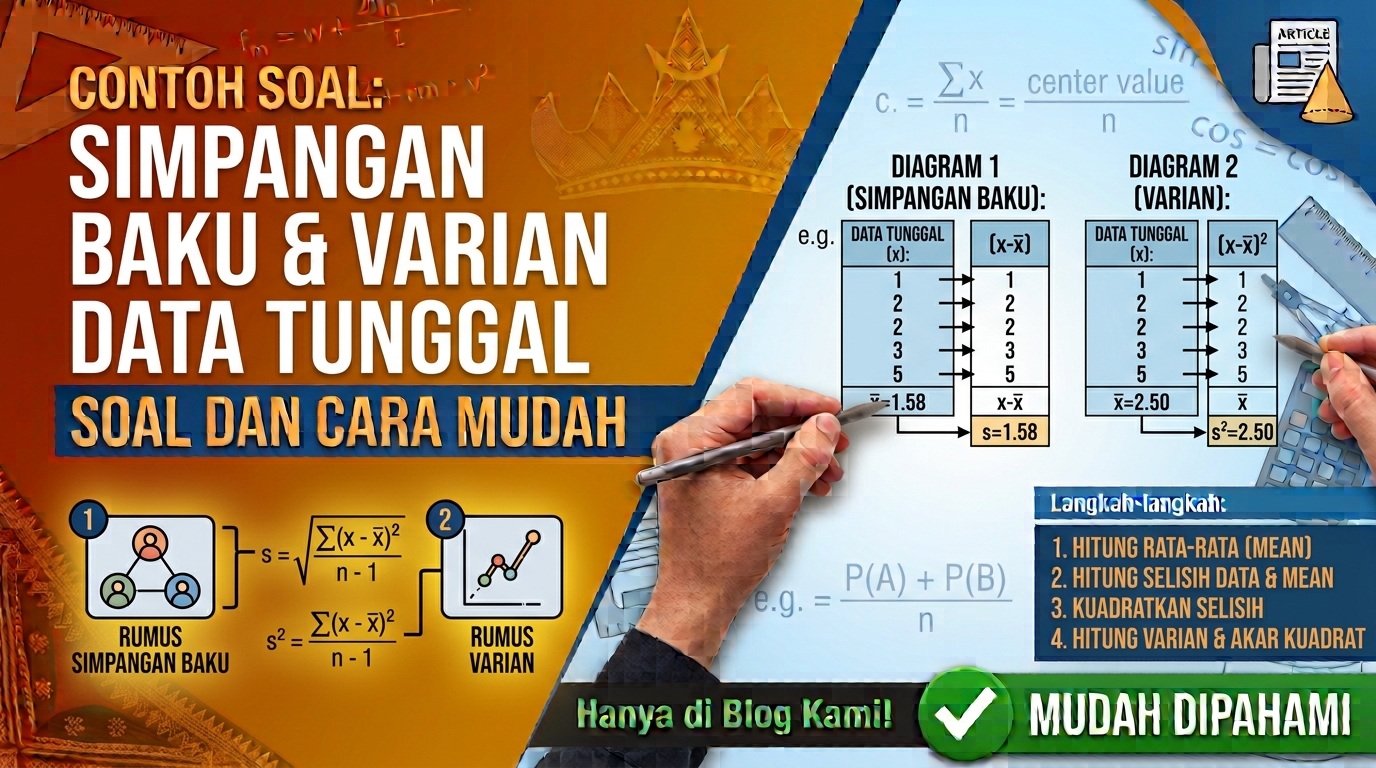
![Dalam materi statistika, simpangan baku dan varian data tunggal menjadi salah satu topik penting yang perlu dipahami. Keduanya digunakan untuk mengetahui seberapa besar penyebaran data terhadap nilai rata-ratanya. Jika data memiliki penyebaran yang kecil, nilai simpangan baku dan variannya juga cenderung kecil. Sebaliknya, semakin jauh data tersebar dari rata-rata, semakin besar pula nilai simpangan baku dan varian. Materi ini sering muncul dalam pembelajaran matematika, terutama ketika membahas statistika dasar. Untuk menguasainya, tidak cukup hanya menghafalkan rumus. Kita juga perlu memahami langkah-langkah menghitung mean, selisih setiap data dengan rata-rata, kuadrat selisih, varian, hingga simpangan baku. Artikel ini akan membahas pengertian, rumus, perbedaan, serta beberapa contoh soal simpangan baku dan varian data tunggal lengkap dengan cara mengerjakannya secara bertahap. Apa Itu Varian? Varian adalah ukuran statistik yang digunakan untuk mengetahui tingkat penyebaran data terhadap nilai rata-ratanya. Varian dihitung dengan mencari rata-rata dari kuadrat selisih setiap data terhadap mean. Dalam data tunggal, terdapat dua jenis rumus varian yang umum digunakan, yaitu varian populasi dan varian sampel. Untuk populasi, rumusnya adalah: σ² = Σ(xᵢ − μ)² / N Keterangan: σ² = varian populasi xᵢ = nilai setiap data μ = rata-rata populasi N = banyak data Σ = jumlah keseluruhan Sementara itu, untuk sampel, rumus varian adalah: s² = Σ(xᵢ − x̄)² / (n − 1) Keterangan: s² = varian sampel xᵢ = nilai setiap data x̄ = rata-rata sampel n = banyak data Dalam soal matematika sekolah, apabila soal menyebutkan sekumpulan data sebagai keseluruhan data yang sedang dianalisis, biasanya digunakan rumus varian populasi. Apa Itu Simpangan Baku? Simpangan baku atau standard deviation adalah akar kuadrat dari varian. Simpangan baku digunakan untuk mengetahui seberapa jauh penyebaran data dari nilai rata-ratanya. Rumus simpangan baku populasi adalah: σ = √[Σ(xᵢ − μ)² / N] Sedangkan untuk sampel: s = √[Σ(xᵢ − x̄)² / (n − 1)] Karena simpangan baku merupakan akar dari varian, keduanya memiliki hubungan yang sangat erat. Jika diketahui: Varian = 16 maka: Simpangan baku = √16 = 4 Jadi, semakin besar nilai varian, biasanya semakin besar pula simpangan bakunya. Perbedaan Varian dan Simpangan Baku Meskipun saling berkaitan, varian dan simpangan baku bukanlah hal yang sama. Varian merupakan rata-rata kuadrat penyimpangan data dari mean. Sementara itu, simpangan baku merupakan akar kuadrat dari varian. Contohnya, jika suatu kumpulan data memiliki varian sebesar 25, maka simpangan bakunya adalah: √25 = 5 Perbedaan lainnya terletak pada satuan. Varian menggunakan satuan yang dikuadratkan, sedangkan simpangan baku memiliki satuan yang sama dengan data aslinya. Karena alasan tersebut, simpangan baku sering kali lebih mudah digunakan untuk menginterpretasikan penyebaran data. Langkah-Langkah Menghitung Varian dan Simpangan Baku Data Tunggal Untuk menyelesaikan soal, terdapat beberapa langkah yang dapat dilakukan. 1. Hitung nilai rata-rata Jumlahkan seluruh data, kemudian bagi dengan banyaknya data. Mean = jumlah seluruh data / banyak data 2. Hitung selisih setiap data dengan mean Setiap nilai data dikurangi dengan rata-rata. xᵢ − x̄ 3. Kuadratkan setiap selisih Hasil pengurangan tadi kemudian dikuadratkan. (xᵢ − x̄)² 4. Jumlahkan seluruh kuadrat selisih Setelah semua data dihitung, jumlahkan hasil kuadrat tersebut. Σ(xᵢ − x̄)² 5. Hitung varian Untuk populasi, jumlah kuadrat selisih dibagi dengan banyak data. 6. Hitung simpangan baku Simpangan baku diperoleh dengan mencari akar kuadrat dari varian. Contoh Soal 1: Menghitung Varian Data Tunggal Soal: Diketahui data nilai ulangan matematika lima siswa sebagai berikut: 6, 7, 8, 9, 10 Tentukan nilai varian dari data tersebut! Pembahasan Langkah pertama adalah menghitung rata-rata. Jumlah data: 6 + 7 + 8 + 9 + 10 = 40 Banyak data: n = 5 Maka: Mean = 40 / 5 = 8 Selanjutnya, hitung selisih setiap data dengan rata-rata. Data (x) x − mean (x − mean)² 6 -2 4 7 -1 1 8 0 0 9 1 1 10 2 4 Jumlah 0 10 Jumlah kuadrat selisih adalah: Σ(x − x̄)² = 10 Karena data tersebut dianggap sebagai populasi, maka: Varian = 10 / 5 Varian = 2 Jadi, varian data tersebut adalah 2. Contoh Soal 2: Menghitung Simpangan Baku Data Tunggal Soal: Tentukan simpangan baku dari data berikut: 5, 6, 7, 8, 9 Pembahasan Pertama, tentukan rata-rata. Jumlah data: 5 + 6 + 7 + 8 + 9 = 35 Banyak data: 5 Maka: Mean = 35 / 5 = 7 Selanjutnya, buat tabel perhitungan. Data x − mean (x − mean)² 5 -2 4 6 -1 1 7 0 0 8 1 1 9 2 4 Jumlah 0 10 Varian: σ² = 10 / 5 = 2 Simpangan baku: σ = √2 Jadi, simpangan bakunya adalah: √2 ≈ 1,41 Dengan demikian, simpangan baku data tersebut sekitar 1,41. Contoh Soal 3: Varian dan Simpangan Baku Sekaligus Soal: Diketahui data tinggi tanaman dalam satu kelompok adalah: 10, 12, 14, 16, 18 Tentukan: Mean Varian Simpangan baku Pembahasan Langkah 1: Menghitung Mean Jumlah seluruh data: 10 + 12 + 14 + 16 + 18 = 70 Banyak data: 5 Maka: Mean = 70 / 5 = 14 Langkah 2: Menghitung Kuadrat Selisih Data x − 14 (x − 14)² 10 -4 16 12 -2 4 14 0 0 16 2 4 18 4 16 Jumlah 0 40 Langkah 3: Menghitung Varian Karena terdapat lima data: σ² = 40 / 5 σ² = 8 Jadi, variannya adalah 8. Langkah 4: Menghitung Simpangan Baku Simpangan baku merupakan akar dari varian. σ = √8 Karena: √8 = √(4 × 2) maka: σ = 2√2 Jika dibulatkan: σ ≈ 2,83 Jadi, hasil akhirnya adalah: Mean = 14 Varian = 8 Simpangan baku ≈ 2,83 Contoh Soal 4: Data dengan Nilai yang Lebih Bervariasi Soal: Perhatikan data berikut: 4, 6, 8, 10, 12, 14 Hitunglah varian dan simpangan bakunya! Pembahasan Jumlah data: 4 + 6 + 8 + 10 + 12 + 14 = 54 Banyak data: 6 Mean: 54 / 6 = 9 Selanjutnya: Data x − 9 (x − 9)² 4 -5 25 6 -3 9 8 -1 1 10 1 1 12 3 9 14 5 25 Jumlah 0 70 Maka varian: σ² = 70 / 6 σ² = 11,67 Kemudian simpangan baku: σ = √11,67 σ ≈ 3,42 Jadi, varian data adalah sekitar 11,67, sedangkan simpangan bakunya sekitar 3,42. Contoh Soal 5: Menghitung Simpangan Baku dari Data Nilai Siswa Soal: Nilai lima siswa dalam sebuah tes adalah: 70, 75, 80, 85, 90 Tentukan varian dan simpangan bakunya! Pembahasan Pertama, hitung rata-rata: Mean = (70 + 75 + 80 + 85 + 90) / 5 Mean = 400 / 5 Mean = 80 Kemudian hitung kuadrat selisih setiap data. Nilai Selisih dari Mean Kuadrat Selisih 70 -10 100 75 -5 25 80 0 0 85 5 25 90 10 100 Jumlah 0 250 Varian: σ² = 250 / 5 σ² = 50 Simpangan baku: σ = √50 σ = 5√2 σ ≈ 7,07 Jadi, varian data adalah 50 dan simpangan bakunya sekitar 7,07. Contoh Soal 6: Menentukan Varian Jika Simpangan Baku Diketahui Soal: Sebuah kumpulan data memiliki simpangan baku sebesar 6. Tentukan nilai variannya! Pembahasan Hubungan antara varian dan simpangan baku adalah: Simpangan baku = √Varian Karena simpangan baku diketahui sebesar 6, maka: Varian = 6² Varian = 36 Jadi, nilai variannya adalah 36. Soal seperti ini relatif lebih mudah karena tidak perlu menghitung mean dan penyimpangan masing-masing data. Contoh Soal 7: Membandingkan Penyebaran Dua Data Soal: Diketahui dua kelompok data berikut. Kelompok A: 7, 8, 9, 10, 11 Kelompok B: 3, 6, 9, 12, 15 Kelompok manakah yang memiliki penyebaran data lebih besar berdasarkan simpangan baku? Pembahasan Kedua kelompok memiliki mean yang sama. Kelompok A: Mean = 9 Kuadrat selisih: 4 + 1 + 0 + 1 + 4 = 10 Varian: 10 / 5 = 2 Simpangan baku: √2 ≈ 1,41 Untuk Kelompok B: Mean = 9 Kuadrat selisih: 36 + 9 + 0 + 9 + 36 = 90 Varian: 90 / 5 = 18 Simpangan baku: √18 ≈ 4,24 Dari hasil tersebut, terlihat bahwa kedua kelompok memiliki rata-rata yang sama, tetapi penyebarannya berbeda. Kelompok A memiliki simpangan baku sekitar 1,41, sedangkan Kelompok B sekitar 4,24. Artinya, nilai-nilai pada Kelompok B tersebar lebih jauh dari rata-ratanya dibandingkan Kelompok A. Tips Cepat Mengerjakan Soal Simpangan Baku dan Varian Agar tidak mudah salah ketika mengerjakan soal, ada beberapa hal yang perlu diperhatikan. 1. Jangan langsung menggunakan rumus simpangan baku Pastikan nilai rata-rata sudah benar terlebih dahulu. Kesalahan pada mean akan memengaruhi seluruh perhitungan berikutnya. 2. Perhatikan tanda negatif Ketika menghitung selisih data dengan mean, hasilnya bisa negatif. Namun, setelah dikuadratkan, hasilnya selalu positif. Misalnya: (6 − 8)² = (-2)² = 4 Bukan -4. 3. Bedakan varian dengan simpangan baku Varian dan simpangan baku memiliki hubungan, tetapi nilainya berbeda. Jika varian = 9, maka: Simpangan baku = √9 = 3 4. Perhatikan apakah data merupakan populasi atau sampel Jika soal meminta varian atau simpangan baku populasi, pembaginya adalah N. Jika soal meminta ukuran sampel dengan rumus sampel, pembaginya adalah n − 1. 5. Gunakan tabel untuk mengurangi kesalahan Untuk data yang cukup banyak, tabel dengan kolom data, selisih dari mean, dan kuadrat selisih akan membuat proses perhitungan lebih teratur. Kesalahan yang Sering Terjadi Ada beberapa kesalahan yang sering dilakukan saat mengerjakan soal simpangan baku dan varian. Pertama, salah menghitung mean. Karena mean menjadi dasar untuk mencari penyimpangan, kesalahan kecil pada tahap ini dapat membuat hasil akhir salah. Kedua, lupa mengkuadratkan selisih. Varian menggunakan kuadrat dari selisih data dengan rata-rata, bukan selisih biasa. Ketiga, salah menentukan pembagi. Untuk populasi digunakan N, sedangkan pada rumus sampel digunakan n − 1. Keempat, menganggap varian sama dengan simpangan baku. Padahal, simpangan baku adalah akar kuadrat dari varian. Kelima, terburu-buru melakukan pembulatan. Sebaiknya gunakan nilai yang lebih presisi selama proses perhitungan dan lakukan pembulatan pada hasil akhir. Kesimpulan Simpangan baku dan varian data tunggal merupakan ukuran yang digunakan untuk mengetahui tingkat penyebaran suatu kumpulan data terhadap nilai rata-ratanya. Varian diperoleh dengan menghitung rata-rata kuadrat selisih setiap data terhadap mean, sedangkan simpangan baku diperoleh dengan mengambil akar kuadrat dari varian. Untuk mengerjakan soal, langkah yang paling aman adalah menghitung mean terlebih dahulu, kemudian mencari selisih setiap data dengan mean, mengkuadratkan selisih tersebut, menjumlahkannya, dan membaginya sesuai jenis data yang digunakan. Setelah mendapatkan varian, simpangan baku dapat diperoleh dengan cara mengambil akar kuadratnya. Dengan memahami alur tersebut, berbagai contoh soal simpangan baku dan varian data tunggal dapat dikerjakan secara lebih mudah dan sistematis. Kunci utamanya bukan hanya menghafal rumus, tetapi memahami hubungan antara rata-rata, penyebaran data, varian, dan simpangan baku.](https://daftarsekolah.spmb.teknokrat.ac.id/wp-content/uploads/2026/09/Gemini_Generated_Image_stezgqstezgqstez.jpeg)


Post Comment