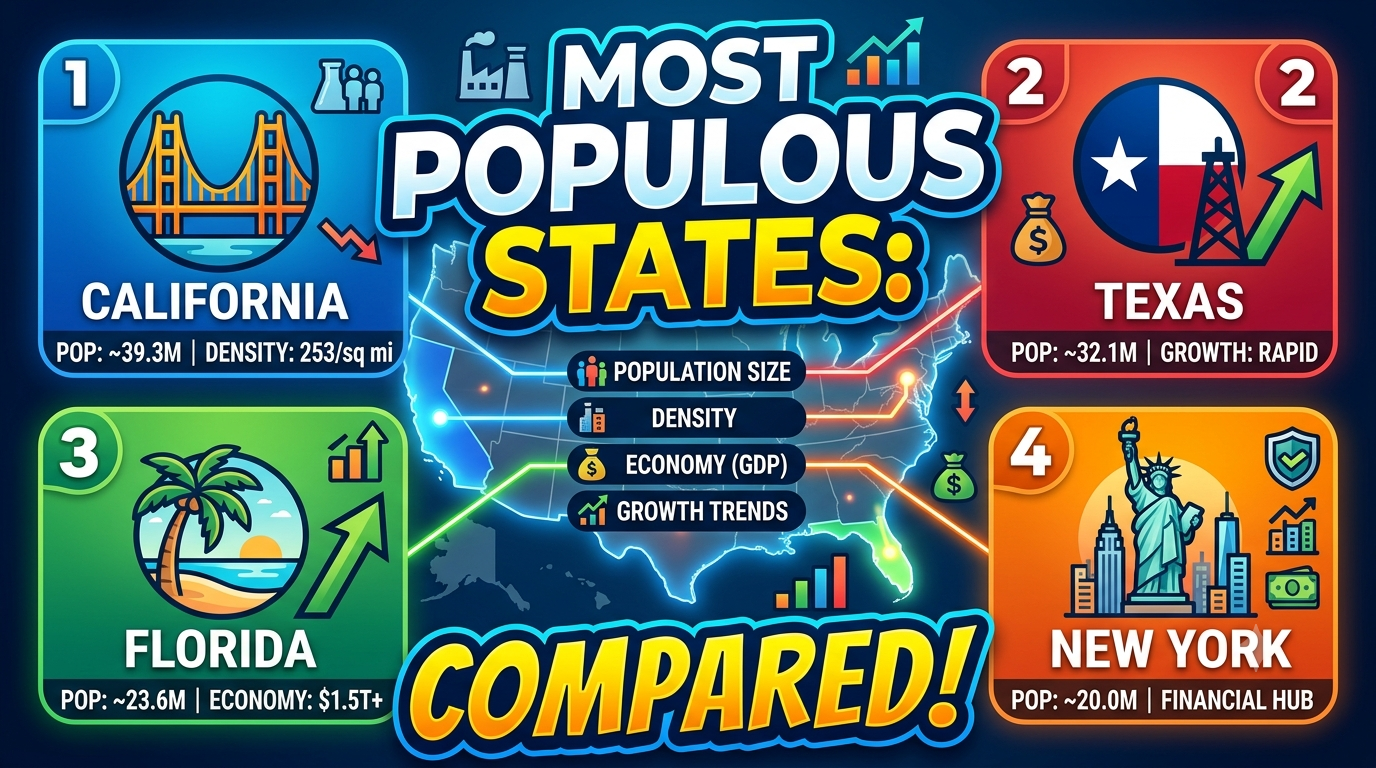
The demographic landscape of the United States is vast, diverse, and constantly evolving. With a national population exceeding 335 million people, human distribution across the 50 states is surprisingly concentrated. In fact, the ten most populous states account for more than 50% of the entire U.S. population.
StatRanker
However, raw population numbers tell only part of the story. Understanding how population size intersects with population density, economic gross domestic product (GDP), and growth trajectories provides crucial insights into real estate markets, labor trends, infrastructure demands, and national policy.
This comprehensive guide analyzes the largest states in the U.S., exploring how heavyweights like California, Texas, Florida, and New York compare across these key demographic and economic metrics.
Overview: The 10 Most Populous U.S. States at a Glance
The following table summarizes the top ten states by population size, highlighting key figures including land area, density, and estimated annual growth trends.
| State | Population Estimate | Population Density (per sq. mi.) | Primary Economic Drivers | Recent Growth Direction |
|---|---|---|---|---|
| California | ~39.3 Million | ~253 | Tech, Entertainment, Agriculture, Trade | Mild Decline / Plateau |
| Texas | ~32.1 Million | ~123 | Energy, Technology, Aerospace, Agriculture | Rapid Growth |
| Florida | ~23.6 Million | ~441 | Tourism, Real Estate, Healthcare, Finance | Rapid Growth |
| New York | ~20.0 Million | ~424 | Financial Services, Tech, Media, Healthcare | Stable / Slight Decline |
| Pennsylvania | ~13.0 Million | ~292 | Healthcare, Manufacturing, Education, Energy | Moderate / Stable |
| Illinois | ~12.7 Million | ~229 | Logistics, Manufacturing, Finance, Tech | Stable / Slight Outflow |
| Ohio | ~11.9 Million | ~292 | Automotive, Healthcare, Aerospace, Agriculture | Moderate / Stable |
| Georgia | ~11.4 Million | ~198 | Logistics, Film/Media, Tech, Agriculture | Steady Growth |
| North Carolina | ~11.3 Million | ~233 | Banking, Biotechnology, Higher Education | Strong Growth |
| Michigan | ~10.1 Million | ~180 | Automotive Industry, Tech, Agriculture, Energy | Slow / Moderate |
In-Depth Analysis: The Top 5 Most Populous States
1. California: The Economic Powerhouse World Population Review
- Population: ~39.3 Million statranker.org+ 1
- Density: ~253 people/sq. mile statranker.org
- Economy: State GDP exceeding $3.8 Trillion (4th/5th largest economy globally if treated as a nation)
California remains the undisputed leader in total population size. Home to nearly 12% of all U.S. residents, the Golden State boasts world-famous metropolitan centers like Los Angeles, San Francisco, and San Diego.
- Economic Engine: Driven by Silicon Valley’s tech ecosystem, Hollywood’s entertainment industry, massive international ports (LA/Long Beach), and Central Valley agriculture.
- Growth Challenge: Despite its economic dominance, California’s population growth has plateaued in recent years. High cost of living, housing affordability issues, and state tax rates have fueled net domestic migration toward Sunbelt states. World Population Review
2. Texas: The Rapidly Growing Titan
- Population: ~32.1 Million statranker.org+ 1
- Density: ~123 people/sq. mile statranker.org
- Economy: State GDP exceeding $2.5 Trillion
Texas holds the second-largest population and is among the fastest-growing mega-states in the nation. Due to its vast geographical area—the largest in the contiguous U.S.—it maintains a relatively moderate population density overall, despite dense urban cores in Houston, Dallas-Fort Worth, Austin, and San Antonio.
World Population Review
- Economic Engine: Traditional strength in oil, natural gas, and agriculture has expanded into massive tech hubs (the “Silicon Hills” of Austin) and corporate headquarters, lured by zero state income tax and favorable business regulations.
- Growth Advantage: Strong domestic in-migration combined with natural birth rates has allowed Texas to gain millions of residents over the past decade.
3. Florida: The High-Density Sunbelt Magnet
- Population: ~23.6 Million statranker.org
- Density: ~441 people/sq. mile statranker.org+ 1
- Economy: State GDP exceeding $1.5 Trillion
Florida surpassed New York in the mid-2010s to secure the rank of third most populous state. Unlike Texas, Florida is geographically narrower, resulting in a much higher population density (441 people per square mile).
World Population Review+ 1
- Economic Engine: Beyond traditional tourism (theme parks, beaches, cruises), Florida has cultivated rapidly growing sectors in finance (the “Wall Street South” in Miami/Palm Beach), aviation, international trade, and specialized healthcare.
- Growth Drivers: A favorable tax climate (no personal state income tax), warm weather, and an influx of both retirees and remote workers continue to drive high net migration rates. World Population Review
4. New York: Dense Urban Center & Global Financial Hub StatRanker
- Population: ~20.0 Million statranker.org+ 1
- Density: ~424 people/sq. mile statranker.org
- Economy: State GDP exceeding $2.1 Trillion
New York is defined by extreme density contrasts. New York City and its immediate suburbs concentrate the vast majority of the state’s residents, whereas Upstate New York features expansive rural and mountainous areas.
- Economic Engine: Global capital of banking, finance (Wall Street), media, fashion, legal services, and international commerce.
- Growth Realities: High urban density and elevated living costs have contributed to domestic out-migration, though international immigration and immense economic productivity maintain New York’s status as a global titan.
5. Pennsylvania: Industrial Heritage and Mid-Atlantic Anchor World Population Review
- Population: ~13.0 Million statranker.org
- Density: ~292 people/sq. mile statranker.org
- Economy: State GDP exceeding $900 Billion
Anchored by Philadelphia in the east and Pittsburgh in the west, Pennsylvania rounds out the top five. It presents a classic example of a mature state economy transitioning from legacy industries to modern technology and service sectors.
- Economic Engine: Major hubs for higher education, healthcare (“eds and meds”), biotechnology, robotics, energy production (natural gas), and manufacturing.
- Growth Profile: Characterized by demographic stability with low-to-moderate population shifts.
Comparing the Key Metrics: Density, Economy, and Growth
To understand the macro forces shaping America, we must look at how these states compare across specific categories.
       TOTAL POPULATION RANKING (TOP 5)
       --------------------------------
       1. California    [████████████████████] ~39.3M
       2. Texas         [███████████████] ~32.1M
       3. Florida       [███████████] ~23.6M
       4. New York      [█████████] ~20.0M
       5. Pennsylvania  [██████] ~13.0M
1. Population Density vs. Spatial Spread
Population density measures how tightly packed residents are within state borders:
StatRanker
- High-Density States: Florida (441/sq. mi.) and New York (424/sq. mi.) face greater pressure on public transportation, housing inventory, and municipal infrastructure. (Smaller states like New Jersey have even higher overall density at 1,300+/sq. mi., but lower total population). World Population Review
- Expansive States: Texas (123/sq. mi.) and California (253/sq. mi.) have large physical footprints. While urban centers like LA or Houston are heavily populated, vast rural expanse keeps statewide averages lower.
2. Economic Output (GDP) per Capita
A state’s total economic output often mirrors its population size, but economic efficiency varies:
- High GDP Giants: California and New York produce disproportionately high GDP output per worker due to concentration in high-value industries like financial trading, software engineering, and biotech.
- Diversifying Economies: Texas, Florida, and North Carolina have successfully boosted their economic output by attracting corporate headquarters fleeing higher-cost states.
3. The Sunbelt vs. Frostbelt Growth Divide
A major demographic shift in the United States over the past decade is the north-to-south and west-to-south migration movement:
- Sunbelt Expansion: States in the South and Southeast (Texas, Florida, Georgia, North Carolina) are experiencing robust population influxes.
- Northeast & Midwest Stabilization: States like New York, Illinois, and Ohio are seeing slower growth or modest domestic outflows, though international immigration helps offset net declines.
Factors Driving State Population Shifts
Why are Americans moving to certain states over others? Key drivers include:
- Tax Structures: States with no state income tax—such as Texas, Florida, Tennessee, and Washington—hold a distinct competitive advantage in attracting both high earners and retirees.
- Housing Affordability: Lower median house prices in Southern and Midwestern markets allow residents to secure larger living spaces for lower costs relative to coastal metros.
- Remote Work Dynamics: The widespread adoption of hybrid and remote work flexible schedules liberated millions of workers from commuting distance of traditional office hubs in NYC or San Francisco, enabling moves to lower-cost regions.
- Business Climate & Regulation: Corporate migrations are driven by favorable regulatory environments, corporate tax incentives, and lower operating costs.
What is the most populous state in the United States? World Population Review
California is the most populous U.S. state, with an estimated population of approximately 39.3 million residents.
World Population Review
Which U.S. state is growing the fastest?
Sunbelt states like Texas, Florida, North Carolina, and South Carolina currently lead the nation in numerical and percentage population growth.
Why is Florida denser than Texas?
Although Texas has more residents overall, Texas covers roughly 268,596 square miles compared to Florida’s 65,757 square miles. Florida’s smaller land footprint compresses its ~23.6 million residents into a higher average density.
StatRanker
What percentage of the U.S. population lives in the top 10 states? StatRanker
The top 10 most populous states account for more than 54% of the entire U.S. resident population.
StatRanker
Conclusion
The distribution of population across the United States reflects a dynamic interplay between historic urban industrial centers and expanding Sunbelt migration magnets. While California, Texas, Florida, and New York continue to anchor the nation’s demographic and economic core, shifting priorities—such as cost of living, tax policies, and remote work flexibility—are actively reshaping where Americans choose to live and work.
As states like Texas and Florida expand their economic footprint and total resident base, infrastructure development, housing policy, and labor market strategies will determine how effectively these population giants sustain their growth in the decades ahead.
Penulis: W.S





Post Comment